 termal
Supervision · Alertes · Connector
Supervision de serveurs sans installer d’agent — et des alertes sans règle à écrire.
Si un serveur a un Termalin Connector, il est déjà supervisé. Une fois par minute, Termalin lit les indicateurs de santé du serveur par la connexion déjà en place, les trace sous forme de graphiques dans l’espace web et vous prévient quand quelque chose ne va pas — un disque bientôt plein, un service en échec, un certificat sur le point d’expirer. Rien de plus à installer, rien à configurer.
Inclus dans Pro et Team · compris dans l’essai Pro de 14 jours · activé par défaut pour chaque Connector
01 / ce que vous voyez
Un tableau de bord par serveur, sans rien à construire.
Ouvrez termal.in/account → Métriques des serveurs. Chaque serveur doté d’un Connector a son propre tableau de bord, sur n’importe quelle période : des 15 dernières minutes à tout l’historique de votre forfait.
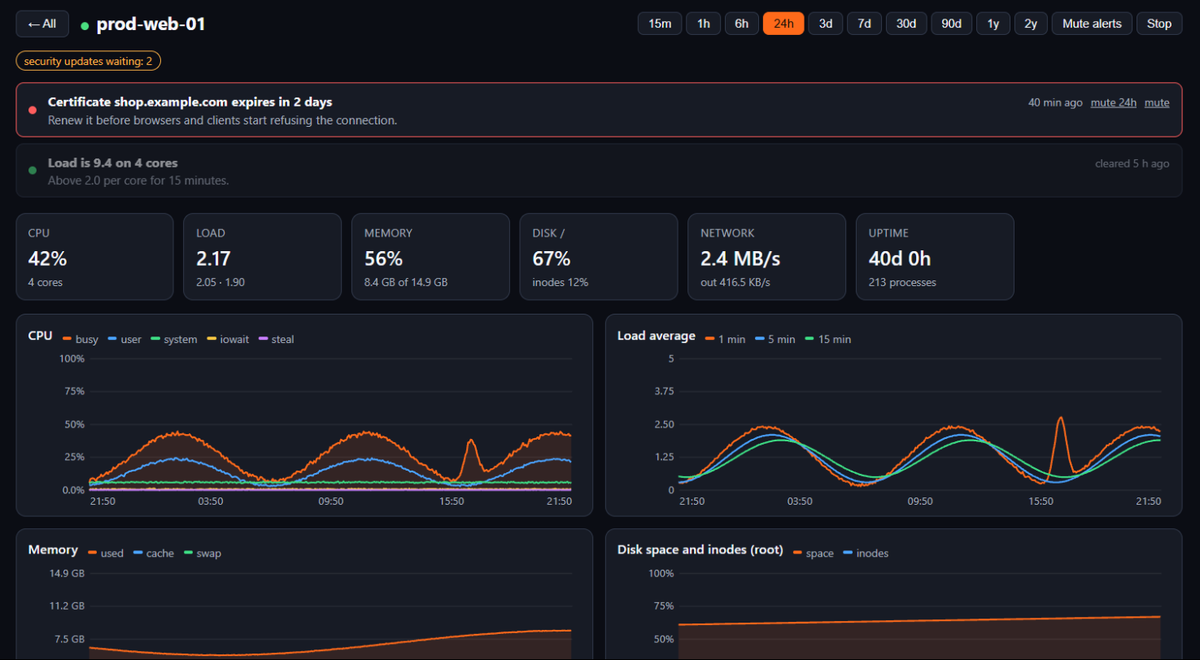
- ▸CPU et charge — occupation, user, system, iowait et steal ; charge moyenne ; pression (PSI).
- ▸Mémoire et swap, espace disque et inodes, E/S disque et occupation du disque.
- ▸Réseau entrant et sortant, sockets TCP, fichiers ouverts, processus.
- ▸Ce qui tourne — conteneurs, services en échec, connexions SSH échouées, mises à jour de sécurité en attente.
- ▸Tableaux — disques, processus les plus gourmands en CPU, conteneurs, certificats TLS avec le nombre de jours avant expiration, services en échec, ports en écoute.
L’historique est conservé 90 jours avec Pro et deux ans avec Team. Les deux dernières semaines sont détaillées à la minute ; l’historique plus ancien est conservé sous forme de moyennes sur cinq minutes, puis sur une heure, qui gardent le pic de chaque intervalle.
02 / alertes
Des alertes qui fonctionnent avant que vous ne configuriez quoi que ce soit.
Chaque serveur supervisé est surveillé avec des seuils par défaut. Vous pouvez les modifier ; rien ne vous y oblige.
- ▸Disque — presque plein (avertissement à 90 %, critique à 95 %), ou qui devrait être plein d’ici un jour. Inodes bientôt épuisés.
- ▸Mémoire et CPU — mémoire saturée, charge élevée de façon prolongée, temps CPU pris par l’hyperviseur (steal), un processus tué faute de mémoire (OOM).
- ▸Services et conteneurs — un service systemd en échec ; un conteneur qui redémarre sans cesse ou qui est unhealthy.
- ▸Certificats — un certificat TLS sur le point d’expirer : 14 jours avant, critique à 3.
- ▸Le serveur lui-même — redémarré ; hors ligne (après trois minutes, pour qu’un redémarrage ne soit pas une alerte) ; une connexion qui ne cesse de tomber.
03 / conçu pour rester discret
Un message quand ça casse. Un quand c’est résolu.
Une alerte n’est utile que si elle est lue : les réglages par défaut limitent donc le nombre de messages.
- ▸Un à l’ouverture, un à la fin. Un message quand un problème apparaît et un quand il est résolu.
- ▸Regroupées. Plusieurs problèmes en quelques minutes arrivent en un seul message. Un problème critique n’attend jamais.
- ▸Pas de répétition par défaut. Un problème qui revient dans la journée n’est pas renvoyé, sauf s’il est critique et qu’il dure.
- ▸Un premier jour calme. Le premier jour de supervision d’un serveur, seules les alertes critiques sont envoyées. Les unités en échec habituelles et les vieux certificats expirés qui traînent sont ignorés.
- ▸Sourdine. Mettez en sourdine un type d’alerte sur un serveur, ou un serveur entier.
04 / canaux
Où vont les alertes.
- ▸E-mail — le canal par défaut.
- ▸Push vers l’app iOS.
- ▸Telegram — un geste suffit pour connecter le bot.
- ▸Webhook — que Slack et Discord acceptent tel quel. Les requêtes sont signées (HMAC-SHA256).
05 / comment ça marche
Ce qui est lu, et comment.
Il n’y a pas d’agent de supervision. Une fois par minute, Termalin exécute quelques commandes en lecture seule — /proc, df, ps et similaires — par la connexion existante du Connector. Le coût pour le serveur : quelques millisecondes de CPU et environ un kilo-octet par minute.
- ▸Activée par défaut, à vous de la désactiver. Un interrupteur pour tous les serveurs et un par serveur, dans Métriques des serveurs. La désactiver efface ce qui a été collecté pour ce serveur.
- ▸Pas de chiffrement de bout en bout. Ces chiffres sont stockés sous une forme que le service peut lire — il doit les lire pour tracer les graphiques et déclencher les alertes.
- ▸Tout est listé. Ce qui est lu figure dans la politique de confidentialité, à la section Server metrics and alerts (en anglais).
- ▸Dans l’espace web pour l’instant. Les tableaux de bord se trouvent sur termal.in/account ; l’application de bureau ne les affiche pas encore. L’app iOS reçoit les notifications push.
06 / applications d’IA
« Comment vont mes serveurs ? » — une réponse tirée des données.
Par l’endpoint MCP hébergé de Termalin, Claude et ChatGPT peuvent lire les mêmes chiffres et les mêmes alertes : server_metrics renvoie les chiffres, alerts_list renvoie les alertes. La réponse vient de ce que la supervision a collecté.
07 / forfaits
Inclus dans Pro et Team.
La supervision a besoin d’un Connector, et les Connectors sont réservés aux forfaits payants — la supervision et les alertes sont donc incluses dans Pro (90 jours d’historique) et Team (deux ans). L’essai Pro de 14 jours les comprend. Elles ne font pas partie du forfait Free. Voir les tarifs →
Questions fréquentes
La supervision installe-t-elle quelque chose sur mon serveur ?
Non. Elle fonctionne pour tout serveur qui a déjà un Termalin Connector, et ne lui ajoute rien : ni second agent, ni exporter, ni port ouvert. Une fois par minute, Termalin exécute quelques commandes en lecture seule (/proc, df, ps et similaires) par la connexion que le Connector maintient déjà.
Que coûte-t-elle au serveur en ressources ?
Quelques millisecondes de CPU et environ un kilo-octet par minute.
Combien de temps l’historique est-il conservé ?
90 jours avec Pro et deux ans avec Team. Les deux dernières semaines sont conservées à la minute ; l’historique plus ancien l’est sous forme de moyennes sur cinq minutes, puis sur une heure, chacune avec le pic de son intervalle : un pic bref reste donc visible sur un graphique long.
Puis-je désactiver la supervision ?
Oui. Il y a un interrupteur pour tous les serveurs et un pour chaque serveur, dans l’espace web, sous Métriques des serveurs. La désactiver efface ce qui a été collecté pour ce serveur. Les alertes ne fonctionnent que pour les serveurs dont la supervision est activée.
Où vont les alertes ?
Par e-mail par défaut. Vous pouvez ajouter un push vers l’app iOS, Telegram (un geste connecte le bot) et un webhook que Slack et Discord acceptent tel quel. Les requêtes de webhook sont signées avec HMAC-SHA256.
Dois-je écrire des règles d’alerte ?
Non. Chaque serveur supervisé est surveillé avec des seuils par défaut — disque, inodes, mémoire, charge, services en échec, conteneurs, certificats, serveur hors ligne. Vous pouvez modifier les seuils ou mettre en sourdine un type d’alerte sur un serveur, mais vous n’avez rien à configurer.
Est-ce que cela remplace Grafana et Prometheus ?
Non. C’est le socle sans configuration : les indicateurs de santé habituels d’un serveur et un jeu d’alertes par défaut, sans rien à déployer. Pas de collecte de logs, pas de métriques personnalisées, pas de vérifications de disponibilité depuis l’extérieur, pas de pages de statut. Si vous exploitez déjà une pile d’observabilité complète, gardez-la ; si vous avez des serveurs que personne ne surveille, cette supervision les surveille.
Connectez un serveur, et il est surveillé.
Une ligne installe le Connector. La supervision est activée par défaut et les alertes ne demandent aucun réglage. Les nouveaux comptes profitent de Pro gratuitement pendant 14 jours.
Pro et Team · essai Pro de 14 jours · Connector · ce qui est lu (en anglais)