 termal
Monitoring · Alarme · Connector
Server-Monitoring ohne Agent-Installation – und Alarme, für die du keine Regeln schreibst.
Hat ein Server einen Termalin Connector, wird er bereits überwacht. Einmal pro Minute liest Termalin die Zustandswerte des Servers über die Verbindung, die ohnehin besteht, zeichnet sie als Diagramme im Web-Kabinett und meldet sich, wenn etwas nicht stimmt – ein Datenträger, der vollzulaufen droht, ein fehlgeschlagener Dienst, ein Zertifikat kurz vor dem Ablauf. Nichts zusätzlich zu installieren, nichts zu konfigurieren.
Teil von Pro und Team · in der 14-tägigen Pro-Testphase enthalten · standardmäßig an für jeden Connector
01 / was du siehst
Ein Dashboard für jeden Server – ohne etwas zu bauen.
Öffne termal.in/account → Servermetriken. Jeder Server mit einem Connector hat sein eigenes Dashboard, für jeden Zeitraum von den letzten 15 Minuten bis zum gesamten Verlauf deines Tarifs.
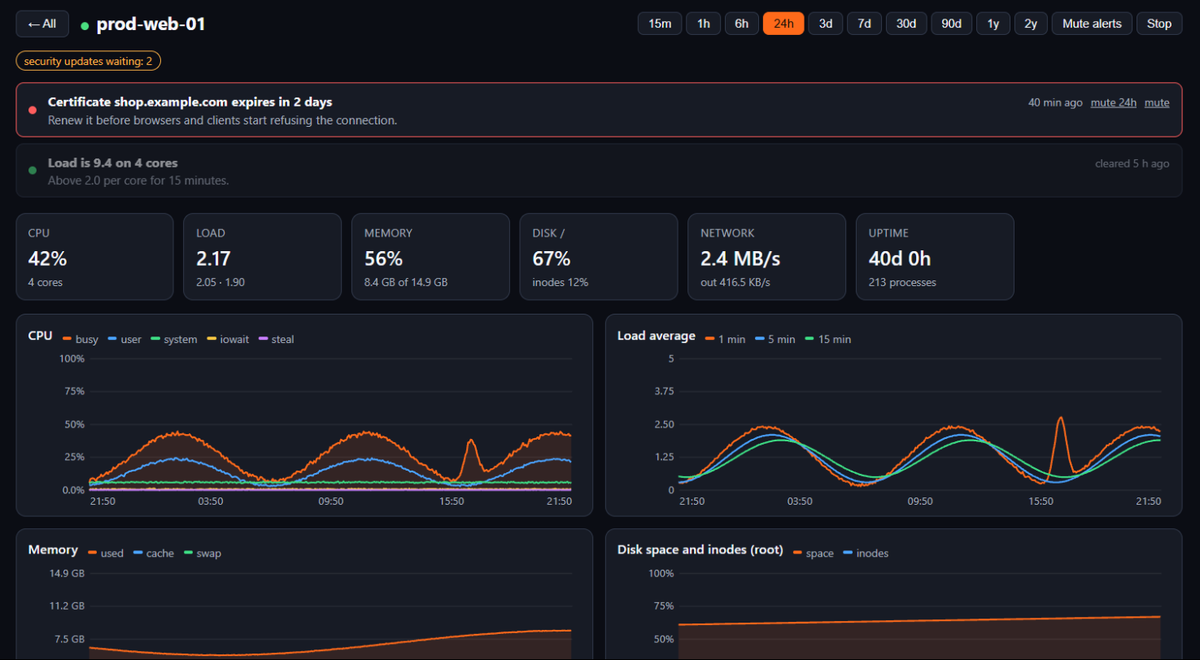
- ▸CPU und Last – Auslastung, user, system, iowait und steal; Load Average; Pressure (PSI).
- ▸Arbeitsspeicher und Swap, Speicherplatz und Inodes, Datenträger-I/O und Datenträgerauslastung.
- ▸Netzwerk ein- und ausgehend, TCP-Sockets, offene Dateien, Prozesse.
- ▸Was läuft – Container, fehlgeschlagene Dienste, fehlgeschlagene SSH-Anmeldungen, ausstehende Sicherheitsupdates.
- ▸Tabellen – Datenträger, Top-Prozesse nach CPU, Container, TLS-Zertifikate mit den Tagen bis zum Ablauf, fehlgeschlagene Dienste, lauschende Ports.
Der Verlauf wird 90 Tage in Pro und zwei Jahre in Team aufbewahrt. Die letzten zwei Wochen liegen minutengenau vor; ältere Daten werden als Fünf-Minuten- und dann als Stundenmittel aufbewahrt, die die Spitze jedes Intervalls behalten.
02 / Alarme
Alarme, die funktionieren, bevor du etwas konfigurierst.
Jeder überwachte Server wird mit Standard-Schwellenwerten beobachtet. Du kannst sie ändern, musst es aber nicht.
- ▸Datenträger – fast voll (Warnung bei 90 %, kritisch bei 95 %) oder laut Prognose innerhalb eines Tages voll. Inodes, die zur Neige gehen.
- ▸Arbeitsspeicher und CPU – Arbeitsspeicher am Anschlag, anhaltend hohe Last, CPU-Zeit, die der Hypervisor abzieht (Steal), ein Out-of-Memory-Kill.
- ▸Dienste und Container – ein fehlgeschlagener systemd-Dienst; ein Container, der immer wieder neu startet oder unhealthy ist.
- ▸Zertifikate – ein TLS-Zertifikat kurz vor dem Ablauf: 14 Tage vorher, kritisch bei 3.
- ▸Der Server selbst – neu gestartet; offline (nach drei Minuten, damit ein Neustart kein Alarm ist); eine Verbindung, die immer wieder abbricht.
03 / bewusst leise
Eine Nachricht, wenn es bricht. Eine, wenn es behoben ist.
Ein Alarm nützt nur, wenn er gelesen wird – deshalb halten die Standardeinstellungen die Zahl der Nachrichten niedrig.
- ▸Einmal rein, einmal raus. Eine Nachricht, wenn ein Problem auftritt, und eine, wenn es behoben ist.
- ▸Gebündelt. Mehrere Probleme innerhalb weniger Minuten kommen als eine Nachricht. Ein kritisches wartet nie.
- ▸Standardmäßig keine Wiederholungen. Ein Problem, das am selben Tag zurückkehrt, wird nicht erneut gesendet – außer es ist kritisch und hält an.
- ▸Ein ruhiger erster Tag. Am ersten Tag, an dem ein Server überwacht wird, werden nur kritische Alarme gesendet. Alltägliche fehlgeschlagene Units und übrig gebliebene abgelaufene Zertifikate werden ignoriert.
- ▸Stummschalten. Schalte eine Art von Alarm auf einem Server stumm – oder einen ganzen Server.
04 / Kanäle
Wohin die Alarme gehen.
- ▸E-Mail – der Standard.
- ▸Push an die iOS-App.
- ▸Telegram – ein Tipp verbindet den Bot.
- ▸Webhook – einer, den Slack und Discord unverändert annehmen. Die Anfragen sind signiert (HMAC-SHA256).
05 / so funktioniert es
Was gelesen wird – und wie.
Es gibt keinen Monitoring-Agenten. Einmal pro Minute führt Termalin ein paar rein lesende Befehle aus – /proc, df, ps und Ähnliches – über die bestehende Verbindung des Connectors. Den Server kostet das ein paar Millisekunden CPU und etwa ein Kilobyte pro Minute.
- ▸Standardmäßig an, von dir abschaltbar. Ein Schalter für alle Server und einer pro Server, unter Servermetriken. Beim Ausschalten wird gelöscht, was für diesen Server gesammelt wurde.
- ▸Nicht Ende-zu-Ende-verschlüsselt. Diese Werte werden so gespeichert, dass der Dienst sie lesen kann – er muss sie lesen, um Diagramme zu zeichnen und Alarme auszulösen.
- ▸Vollständig aufgelistet. Was gelesen wird, steht in der Datenschutzerklärung unter Server metrics and alerts (auf Englisch).
- ▸Vorerst im Web-Kabinett. Die Dashboards liegen unter termal.in/account; die Desktop-App zeigt sie noch nicht. Die iOS-App empfängt die Push-Nachrichten.
06 / KI-Apps
„Wie geht es meinen Servern?“ – beantwortet aus Daten.
Über den gehosteten MCP-Endpoint von Termalin können Claude und ChatGPT dieselben Werte und dieselben Alarme lesen: server_metrics liefert die Werte, alerts_list die Alarme. Die Antwort stammt aus dem, was das Monitoring gesammelt hat.
07 / Tarife
Teil von Pro und Team.
Monitoring braucht einen Connector, und Connectors gibt es in den bezahlten Tarifen – Monitoring und Alarme gehören also zu Pro (90 Tage Verlauf) und Team (zwei Jahre). Die 14-tägige Pro-Testphase enthält sie. Im Free-Tarif sind sie nicht dabei. Preise ansehen →
Fragen
Installiert das Server-Monitoring etwas auf meinem Server?
Nein. Es funktioniert für jeden Server, der bereits einen Termalin Connector hat, und fügt ihm nichts hinzu: keinen zweiten Agenten, keinen Exporter, keinen offenen Port. Einmal pro Minute führt Termalin ein paar rein lesende Befehle aus (/proc, df, ps und Ähnliches) – über die Verbindung, die der Connector ohnehin hält.
Was kostet es den Server an Ressourcen?
Ein paar Millisekunden CPU und etwa ein Kilobyte pro Minute.
Wie lange wird der Verlauf aufbewahrt?
90 Tage in Pro und zwei Jahre in Team. Die letzten zwei Wochen werden minutengenau aufbewahrt; ältere Daten als Fünf-Minuten- und dann als Stundenmittel, jeweils mit der Spitze ihres Intervalls, sodass eine kurze Spitze auch in einem langen Diagramm sichtbar bleibt.
Kann ich das Monitoring ausschalten?
Ja. Es gibt einen Schalter für alle Server und einen für jeden Server, im Web-Kabinett unter Servermetriken. Beim Ausschalten wird gelöscht, was für diesen Server gesammelt wurde. Alarme funktionieren nur für Server mit eingeschaltetem Monitoring.
Wohin gehen die Alarme?
Standardmäßig per E-Mail. Du kannst Push an die iOS-App, Telegram (ein Tipp verbindet den Bot) und einen Webhook hinzufügen, den Slack und Discord unverändert annehmen. Webhook-Anfragen sind mit HMAC-SHA256 signiert.
Muss ich Alarmregeln schreiben?
Nein. Jeder überwachte Server wird mit Standard-Schwellenwerten beobachtet – Datenträger, Inodes, Arbeitsspeicher, Last, fehlgeschlagene Dienste, Container, Zertifikate, ein Server, der offline geht. Du kannst die Schwellenwerte ändern oder eine Art von Alarm auf einem Server stummschalten, musst aber nichts einrichten.
Ersetzt das Grafana und Prometheus?
Nein. Es ist die Grundausstattung ohne Einrichtung: die üblichen Zustandswerte eines Servers und ein Standardsatz an Alarmen, ohne dass du etwas ausrollen musst. Es gibt keine Log-Sammlung, keine eigenen Metriken, keine Uptime-Checks von außen und keine Statusseiten. Wenn du bereits einen vollständigen Observability-Stack betreibst, behalte ihn; wenn du Server hast, die überhaupt niemand beobachtet, beobachtet dieses Monitoring sie.
Verbinde einen Server – und er wird überwacht.
Eine Zeile installiert den Connector. Das Monitoring ist standardmäßig an, und Alarme brauchen keine Einrichtung. Neue Konten bekommen Pro 14 Tage kostenlos.
Pro und Team · 14-tägige Pro-Testphase · Connector · was gelesen wird (auf Englisch)