 termal
Monitorización · Alertas · Connector
Monitorización de servidores sin instalar un agente — y alertas sin reglas que escribir.
Si un servidor tiene un Termalin Connector, ya está monitorizado. Una vez por minuto Termalin lee los indicadores de salud del servidor por la conexión que ya existe, los dibuja como gráficas en el panel web y te avisa cuando algo va mal — un disco a punto de llenarse, un servicio fallido, un certificado a punto de caducar. Nada extra que instalar, nada que configurar.
Incluido en Pro y Team · incluido en los 14 días de Pro de prueba · activado por defecto en cada Connector
01 / lo que ves
Un panel para cada servidor, sin nada que montar.
Abre termal.in/account → Métricas de servidores. Cada servidor con un Connector tiene su propio panel, en cualquier intervalo: desde los últimos 15 minutos hasta todo el historial de tu plan.
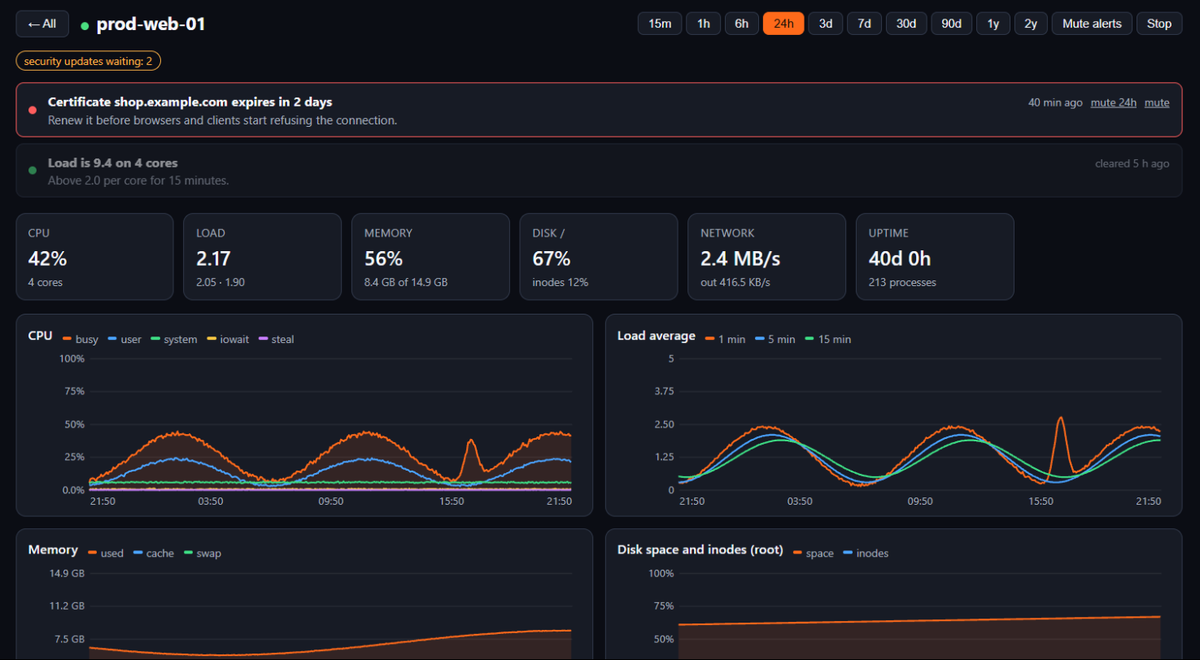
- ▸CPU y carga — ocupación, user, system, iowait y steal; carga media; presión (PSI).
- ▸Memoria y swap, espacio en disco e inodes, E/S de disco y ocupación del disco.
- ▸Red de entrada y de salida, sockets TCP, archivos abiertos, procesos.
- ▸Qué está en marcha — contenedores, servicios fallidos, inicios de sesión SSH fallidos, actualizaciones de seguridad pendientes.
- ▸Tablas — discos, procesos que más CPU consumen, contenedores, certificados TLS con los días que faltan para que caduquen, servicios fallidos, puertos a la escucha.
El historial se guarda 90 días en Pro y dos años en Team. Las dos últimas semanas tienen detalle de un minuto; el historial más antiguo se guarda como medias de cinco minutos y después de una hora, que conservan el pico de cada intervalo.
02 / alertas
Alertas que funcionan antes de que configures nada.
Cada servidor monitorizado se vigila con umbrales por defecto. Puedes cambiarlos; no hace falta.
- ▸Disco — casi lleno (aviso al 90 %, crítico al 95 %), o con previsión de llenarse en menos de un día. Inodes a punto de agotarse.
- ▸Memoria y CPU — memoria al límite, carga alta de forma sostenida, tiempo de CPU que se lleva el hipervisor (steal), un proceso terminado por falta de memoria (OOM).
- ▸Servicios y contenedores — un servicio de systemd fallido; un contenedor que no para de reiniciarse o que está en estado unhealthy.
- ▸Certificados — un certificado TLS a punto de caducar: aviso 14 días antes, crítico a los 3.
- ▸El propio servidor — se ha reiniciado; está desconectado (tras tres minutos, para que un reinicio no sea una alerta); una conexión que no deja de caerse.
03 / pensado para no molestar
Un mensaje cuando se rompe. Otro cuando se resuelve.
Una alerta solo sirve si se lee, así que los valores por defecto mantienen bajo el número de mensajes.
- ▸Uno al empezar, uno al terminar. Un mensaje cuando se abre un problema y otro cuando se resuelve.
- ▸Agrupadas. Varios problemas en pocos minutos llegan en un solo mensaje. Uno crítico nunca espera.
- ▸Sin repeticiones por defecto. Un problema que vuelve el mismo día no se envía de nuevo, salvo que sea crítico y se prolongue.
- ▸Un primer día tranquilo. El primer día que se monitoriza un servidor solo se envían las alertas críticas. Las unidades fallidas rutinarias y los certificados caducados que quedaron olvidados se ignoran.
- ▸Silenciar. Silencia un tipo de alerta en un servidor, o un servidor entero.
04 / canales
A dónde van las alertas.
- ▸Correo — el canal por defecto.
- ▸Push a la app de iOS.
- ▸Telegram — un toque para conectar el bot.
- ▸Webhook — uno que Slack y Discord aceptan tal cual. Las peticiones van firmadas (HMAC-SHA256).
05 / cómo funciona
Qué se lee y cómo.
No hay agente de monitorización. Una vez por minuto Termalin ejecuta unos pocos comandos de solo lectura — /proc, df, ps y similares — por la conexión que el Connector ya tiene. Al servidor le cuesta unos milisegundos de CPU y alrededor de un kilobyte por minuto.
- ▸Activado por defecto; tú decides si lo desactivas. Un interruptor para todos los servidores y uno por servidor, en Métricas de servidores. Al desactivarlo se borra lo recopilado de ese servidor.
- ▸Sin cifrado de extremo a extremo. Estas cifras se guardan de forma que el servicio puede leerlas — tiene que leerlas para dibujar las gráficas y lanzar las alertas.
- ▸Detallado por completo. Lo que se lee figura en la política de privacidad, en el apartado Server metrics and alerts (en inglés).
- ▸Por ahora, en el panel web. Los paneles están en termal.in/account; la aplicación de escritorio todavía no los muestra. La app de iOS recibe las notificaciones push.
06 / apps de IA
«¿Cómo están mis servidores?» — respondido con datos.
A través del endpoint MCP alojado de Termalin, Claude y ChatGPT pueden leer las mismas cifras y las mismas alertas: server_metrics devuelve las cifras y alerts_list, las alertas. La respuesta sale de lo que la monitorización ha recopilado.
07 / planes
Incluido en Pro y Team.
La monitorización necesita un Connector, y los Connectors son una función de los planes de pago — así que la monitorización y las alertas vienen con Pro (90 días de historial) y Team (dos años). Los 14 días de Pro de prueba las incluyen. No están en el plan Free. Ver precios →
Preguntas
¿La monitorización instala algo en mi servidor?
No. Funciona en cualquier servidor que ya tenga un Termalin Connector y no le añade nada: ni un segundo agente, ni un exporter, ni un puerto abierto. Una vez por minuto Termalin ejecuta unos pocos comandos de solo lectura (/proc, df, ps y similares) por la conexión que el Connector ya mantiene.
¿Cuánto le cuesta al servidor en recursos?
Unos milisegundos de CPU y alrededor de un kilobyte por minuto.
¿Cuánto tiempo se guarda el historial?
90 días en Pro y dos años en Team. Las dos últimas semanas se guardan con detalle de un minuto; el historial más antiguo se guarda como medias de cinco minutos y después de una hora, cada una con el pico de su intervalo, así que un pico breve sigue viéndose en una gráfica larga.
¿Puedo desactivar la monitorización?
Sí. Hay un interruptor para todos los servidores y uno para cada servidor, en el panel web, en Métricas de servidores. Al desactivarlo se borra lo recopilado de ese servidor. Las alertas solo funcionan en los servidores con la monitorización activada.
¿A dónde llegan las alertas?
Por defecto, al correo. Puedes añadir push a la app de iOS, Telegram (un toque conecta el bot) y un webhook que Slack y Discord aceptan tal cual. Las peticiones del webhook van firmadas con HMAC-SHA256.
¿Tengo que escribir reglas de alerta?
No. Cada servidor monitorizado se vigila con umbrales por defecto — disco, inodes, memoria, carga, servicios fallidos, contenedores, certificados, el servidor desconectado. Puedes cambiar los umbrales o silenciar un tipo de alerta en un servidor, pero no tienes que configurar nada.
¿Sustituye a Grafana y Prometheus?
No. Es la base sin configuración: los indicadores de salud habituales de un servidor y un conjunto de alertas por defecto, sin nada que desplegar. No recoge logs, no tiene métricas personalizadas, ni comprobaciones de disponibilidad desde fuera, ni páginas de estado. Si ya tienes una pila de observabilidad completa, consérvala; si tienes servidores que nadie vigila, esto los vigila.
Conecta un servidor y queda vigilado.
Una línea instala el Connector. La monitorización está activada por defecto y las alertas no necesitan configuración. Las cuentas nuevas tienen Pro gratis durante 14 días.
Pro y Team · 14 días de Pro de prueba · Connector · qué se lee (en inglés)