 termal
Monitoramento · Alertas · Connector
Monitoramento de servidores sem instalar um agente — e alertas sem regras para escrever.
Se um servidor tem um Connector do Termalin, ele já está sendo monitorado. Uma vez por minuto, o Termalin lê os indicadores de saúde do servidor pela conexão que já existe, mostra tudo em gráficos no painel web e avisa quando algo está errado — um disco prestes a encher, um serviço com falha, um certificado prestes a expirar. Nada a mais para instalar, nada para configurar.
Parte do Pro e do Team · incluído nos 14 dias de teste do Pro · ativado por padrão em todo Connector
01 / o que você vê
Um dashboard para cada servidor, sem nada para montar.
Abra termal.in/account → Métricas do servidor. Cada servidor com um Connector tem seu próprio dashboard, em qualquer período — dos últimos 15 minutos até o histórico completo do seu plano.
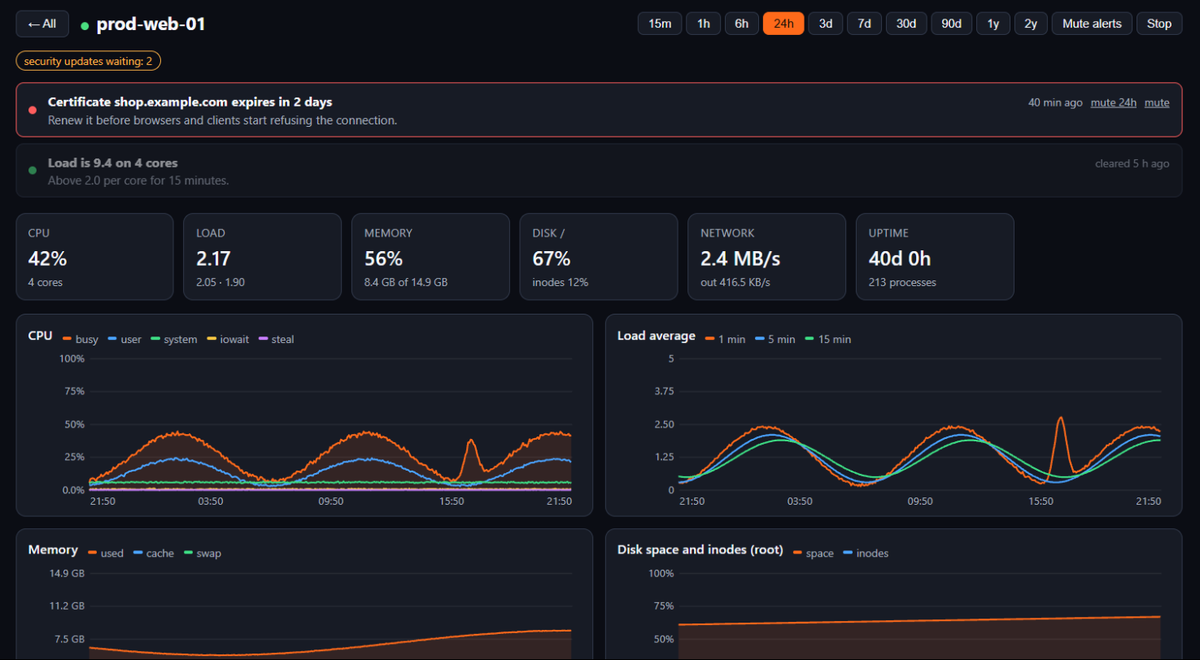
- ▸CPU e carga — uso total, user, system, iowait e steal; carga média; pressão (PSI).
- ▸Memória e swap, espaço em disco e inodes, E/S de disco e ocupação do disco.
- ▸Rede de entrada e de saída, sockets TCP, arquivos abertos, processos.
- ▸O que está em execução — contêineres, serviços com falha, tentativas de login SSH com falha, atualizações de segurança pendentes.
- ▸Tabelas — discos, principais processos por CPU, contêineres, certificados TLS com os dias até a expiração, serviços com falha, portas em escuta.
O histórico fica guardado por 90 dias no Pro e dois anos no Team. As duas semanas mais recentes têm detalhe de um minuto; o histórico mais antigo fica como médias de cinco minutos e, depois, de uma hora, que preservam o pico de cada intervalo.
02 / alertas
Alertas que funcionam antes de você configurar qualquer coisa.
Todo servidor monitorado é acompanhado com limites padrão. Você pode alterá-los; não precisa.
- ▸Disco — quase cheio (aviso em 90%, crítico em 95%) ou com previsão de encher em menos de um dia. Inodes acabando.
- ▸Memória e CPU — memória no limite, carga alta por tempo prolongado, tempo de CPU tomado pelo hipervisor (steal), um processo encerrado por falta de memória (OOM kill).
- ▸Serviços e contêineres — um serviço do systemd com falha; um contêiner que fica reiniciando ou está unhealthy.
- ▸Certificados — um certificado TLS prestes a expirar: 14 dias antes, crítico a 3.
- ▸O próprio servidor — reiniciado; off-line (depois de três minutos, para que uma reinicialização não vire alerta); uma conexão que fica caindo.
03 / feito para ser discreto
Uma mensagem quando quebra. Uma quando se resolve.
Um alerta só serve se for lido, então os padrões mantêm baixo o número de mensagens.
- ▸Uma na entrada, uma na saída. Uma mensagem quando um problema começa e uma quando é resolvido.
- ▸Agrupados. Vários problemas em poucos minutos chegam como uma única mensagem. Um problema crítico nunca espera.
- ▸Sem repetições por padrão. Um problema que volta no mesmo dia não é enviado de novo, a menos que seja crítico e persista.
- ▸Um primeiro dia tranquilo. No primeiro dia de monitoramento de um servidor, só os alertas críticos são enviados. Units com falhas rotineiras e certificados vencidos esquecidos são ignorados.
- ▸Silenciar. Silencie um tipo de alerta em um servidor, ou um servidor inteiro.
04 / canais
Para onde vão os alertas.
- ▸E-mail — o padrão.
- ▸Push para o app iOS.
- ▸Telegram — um toque para conectar o bot.
- ▸Webhook — que o Slack e o Discord aceitam como está. As requisições são assinadas (HMAC-SHA256).
05 / como funciona
O que é lido, e como.
Não há agente de monitoramento. Uma vez por minuto, o Termalin executa alguns comandos somente leitura — /proc, df, ps e semelhantes — pela conexão que o Connector já mantém. O custo para o servidor é de alguns milissegundos de CPU e cerca de um kilobyte por minuto.
- ▸Ativado por padrão, e você pode desativar. Uma opção para todos os servidores e uma por servidor, em Métricas do servidor. Desativá-lo apaga o que foi coletado desse servidor.
- ▸Sem criptografia de ponta a ponta. Esses números são armazenados de uma forma que o serviço consegue ler — ele precisa lê-los para desenhar os gráficos e gerar os alertas.
- ▸Listado por completo. O que é lido está listado na política de privacidade, em Server metrics and alerts (em inglês).
- ▸Por enquanto, no painel web. Os dashboards ficam em termal.in/account; o app de desktop ainda não os mostra. O app iOS recebe os pushes.
06 / apps de IA
“Como estão meus servidores?” — respondido com dados.
Pelo endpoint MCP hospedado do Termalin, o Claude e o ChatGPT conseguem ler os mesmos números e os mesmos alertas: server_metrics devolve os números, alerts_list devolve os alertas. A resposta vem do que o monitoramento coletou.
07 / planos
Parte do Pro e do Team.
O monitoramento precisa de um Connector, e os Connectors são um recurso dos planos pagos — por isso o monitoramento e os alertas vêm com o Pro (90 dias de histórico) e o Team (dois anos). Os 14 dias de teste do Pro os incluem. Não estão no plano Free. Ver preços →
Perguntas frequentes
O monitoramento de servidores instala alguma coisa no meu servidor?
Não. Funciona em todo servidor que já tem um Connector do Termalin e não acrescenta nada a ele: nenhum segundo agente, nenhum exporter, nenhuma porta aberta. Uma vez por minuto, o Termalin executa alguns comandos somente leitura (/proc, df, ps e semelhantes) pela conexão que o Connector já mantém.
Quanto isso custa ao servidor em recursos?
Alguns milissegundos de CPU e cerca de um kilobyte por minuto.
Por quanto tempo o histórico fica guardado?
90 dias no Pro e dois anos no Team. As duas semanas mais recentes ficam com detalhe de um minuto; o histórico mais antigo fica como médias de cinco minutos e, depois, de uma hora, cada uma com o pico do seu intervalo — assim, um pico curto ainda aparece num gráfico longo.
Posso desativar o monitoramento?
Sim. Há uma opção para todos os servidores e uma para cada servidor, no painel web, em Métricas do servidor. Desativá-lo apaga o que foi coletado desse servidor. Os alertas só funcionam nos servidores com o monitoramento ativado.
Para onde vão os alertas?
Para o e-mail, por padrão. Você pode acrescentar push para o app iOS, Telegram (um toque conecta o bot) e um webhook que o Slack e o Discord aceitam como está. As requisições de webhook são assinadas com HMAC-SHA256.
Preciso escrever regras de alerta?
Não. Todo servidor monitorado é acompanhado com limites padrão — disco, inodes, memória, carga, serviços com falha, contêineres, certificados, o servidor ficar off-line. Você pode alterar os limites ou silenciar um tipo de alerta em um servidor, mas não precisa configurar nada.
Isso substitui o Grafana e o Prometheus?
Não. É a base que não exige configuração: os indicadores padrão de saúde de um servidor e um conjunto padrão de alertas, sem nada para implantar. Não tem coleta de logs, métricas personalizadas, verificações externas de disponibilidade nem páginas de status. Se você já mantém uma pilha completa de observabilidade, continue com ela; se tem servidores que ninguém acompanha, isto passa a acompanhá-los.
Conecte um servidor, e ele passa a ser acompanhado.
Uma linha instala o Connector. O monitoramento vem ativado por padrão, e os alertas não exigem configuração. Contas novas ganham o Pro grátis por 14 dias.
Pro e Team · 14 dias de teste do Pro · Connector · o que é lido (em inglês)