 termal
监控 · 告警 · Connector
无需安装监控代理的服务器监控,无需编写规则的告警
服务器只要装有 Termalin Connector,就已经在监控之中。Termalin 每分钟通过已有的连接读取服务器的健康指标,在网页控制台中绘成图表,并在出问题时通知你:磁盘快满了、服务失败了、证书快过期了。无需额外安装,也无需配置。
包含在 Pro 和 Team 中 · 14 天 Pro 试用期间可用 · 每个 Connector 默认开启
01 / 你能看到什么
每台服务器一个仪表盘,无需自己搭建
打开 termal.in/account → 服务器指标。每台装有 Connector 的服务器都有自己的仪表盘,时间范围可以从最近 15 分钟一直到你的套餐所保留的全部历史。
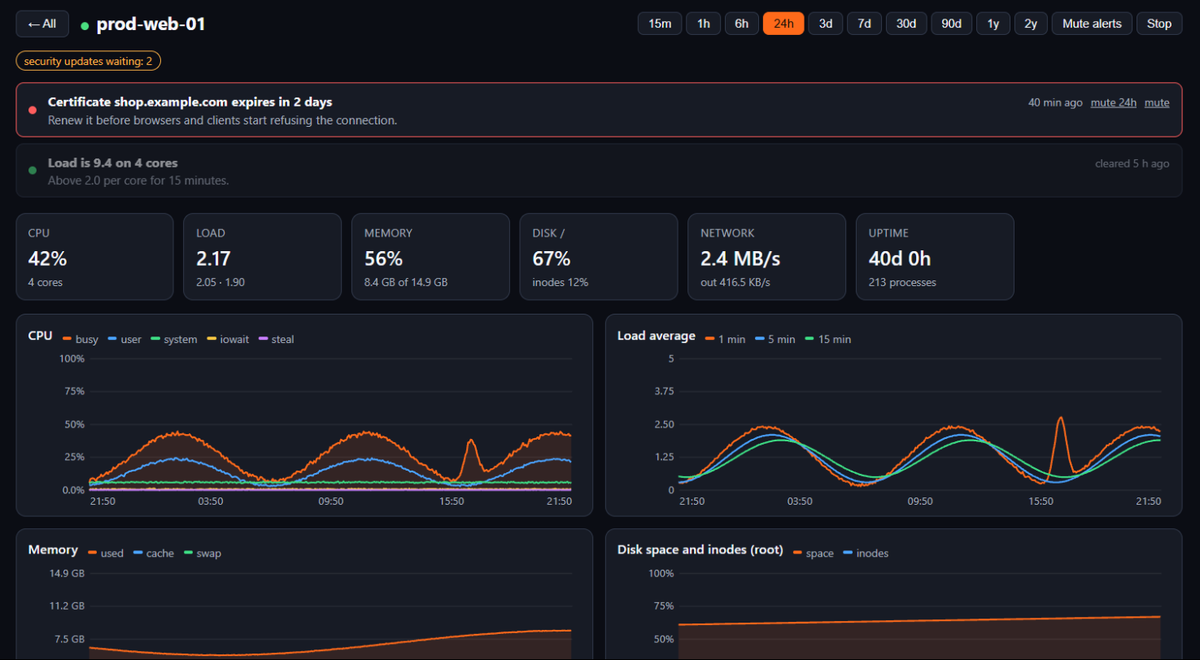
- ▸CPU 和负载:总占用、user、system、iowait 和 steal;平均负载;压力(PSI)。
- ▸内存和 swap、磁盘空间和 inode、磁盘 I/O 和磁盘繁忙度。
- ▸网络入站和出站流量、TCP 套接字、打开的文件数、进程数。
- ▸正在运行什么:容器、失败的服务、失败的 SSH 登录、待安装的安全更新。
- ▸表格:磁盘、按 CPU 排序的进程、容器、TLS 证书及距过期的天数、失败的服务、监听端口。
历史数据在 Pro 保留 90 天,在 Team 保留两年。最近两周是一分钟粒度;更早的历史先按五分钟、再按一小时的平均值保存,并保留每个区间的峰值。
02 / 告警
什么都不用配置,告警就已生效
每台受监控的服务器都按默认阈值监控。阈值可以改,但不是必须改。
- ▸磁盘:快满了(90% 警告,95% 严重),或预计一天内写满。inode 即将耗尽。
- ▸内存和 CPU:内存持续吃紧、负载长时间偏高、CPU 时间被虚拟化层占用(steal)、发生 OOM kill。
- ▸服务和容器:某个 systemd 服务失败;某个容器不断重启或处于 unhealthy 状态。
- ▸证书:TLS 证书即将过期,提前 14 天提醒,剩 3 天时升为严重。
- ▸服务器本身:重启过;离线(三分钟后才告警,所以一次重启不会触发告警);连接频繁断开。
03 / 为安静而设计
出问题时一条消息,恢复时一条消息
告警有人看才有用,所以默认设置会把消息数量压到最低。
- ▸来一条,去一条。问题出现时发一条消息,恢复时再发一条。
- ▸合并发送。几分钟内出现的多个问题合并成一条消息。严重问题从不等待。
- ▸默认不重复。同一天内再次出现的问题不会再次发送,除非是严重问题且持续存在。
- ▸平静的第一天。服务器开始监控的第一天只发送严重告警。例行失败的 unit 和遗留的过期证书会被忽略。
- ▸静音。可以在某台服务器上静音某一类告警,也可以静音整台服务器。
04 / 渠道
告警发到哪里
- ▸电子邮件:默认渠道。
- ▸推送:发到 iOS App。
- ▸Telegram:点一下即可连接机器人。
- ▸Webhook:Slack 和 Discord 可以直接接收。请求带签名(HMAC-SHA256)。
05 / 工作原理
读取什么,怎么读取
没有监控代理。Termalin 每分钟通过 Connector 已有的连接运行几条只读命令(/proc、df、ps 等)。对服务器的开销是几毫秒的 CPU 时间和每分钟大约 1 KB 数据。
- ▸默认开启,可随时关闭。在“服务器指标”中,有一个针对所有服务器的开关,每台服务器也各有一个。关闭监控会清除该服务器已收集的数据。
- ▸不是端到端加密。这些数字以服务可读的形式存储,因为服务必须读取它们才能绘制图表、发出告警。
- ▸完整列出。读取的内容都列在隐私政策的 Server metrics and alerts(英文)一节中。
- ▸目前只在网页控制台中。仪表盘位于 termal.in/account;桌面应用暂时还不显示。iOS App 可以接收推送。
07 / 套餐
包含在 Pro 和 Team 中
监控需要 Connector,而 Connector 是付费套餐的功能,所以监控和告警随 Pro(90 天历史)和 Team(两年)提供。14 天 Pro 试用也包含它们。Free 版不提供。查看价格 →
常见问题
服务器监控会在我的服务器上安装什么吗?
不会。只要服务器已经装有 Termalin Connector,监控就能工作,而且不会往服务器上添加任何东西:没有第二个代理程序,没有 exporter,也不开放端口。Termalin 每分钟通过 Connector 已有的连接运行几条只读命令(/proc、df、ps 等)。
会占用服务器多少资源?
几毫秒的 CPU 时间,每分钟大约 1 KB 数据。
历史数据保留多久?
Pro 保留 90 天,Team 保留两年。最近两周保留一分钟粒度的数据;更早的历史先按五分钟、再按一小时的平均值保存,并保留每个区间的峰值,所以短暂的尖峰在长时间范围的图表上仍然看得到。
可以关闭监控吗?
可以。在网页控制台的服务器指标中,有一个针对所有服务器的开关,每台服务器也各有一个开关。关闭监控会清除该服务器已收集的数据。只有开启监控的服务器才会产生告警。
告警发到哪里?
默认发到电子邮件。还可以添加 iOS App 推送、Telegram(点一下即可连接机器人),以及 Slack 和 Discord 可以直接接收的 webhook。webhook 请求使用 HMAC-SHA256 签名。
需要自己写告警规则吗?
不需要。每台受监控的服务器都按默认阈值监控:磁盘、inode、内存、负载、失败的服务、容器、证书、服务器离线。你可以修改阈值,或在某台服务器上静音某一类告警,但什么都不设置也能用。
它能替代 Grafana 和 Prometheus 吗?
不能。它是零配置的基础监控:一台服务器的常规健康指标加一套默认告警,无需部署任何东西。它不收集日志,不支持自定义指标,没有来自外部的可用性探测,也没有状态页。如果你已经在运行完整的可观测性方案,继续用它;如果你有完全没人盯着的服务器,就交给它来盯。